
系列:30 天打造企業級 PLM|面向:遷移|素材:資料匯出工具架構設計(概念層級)
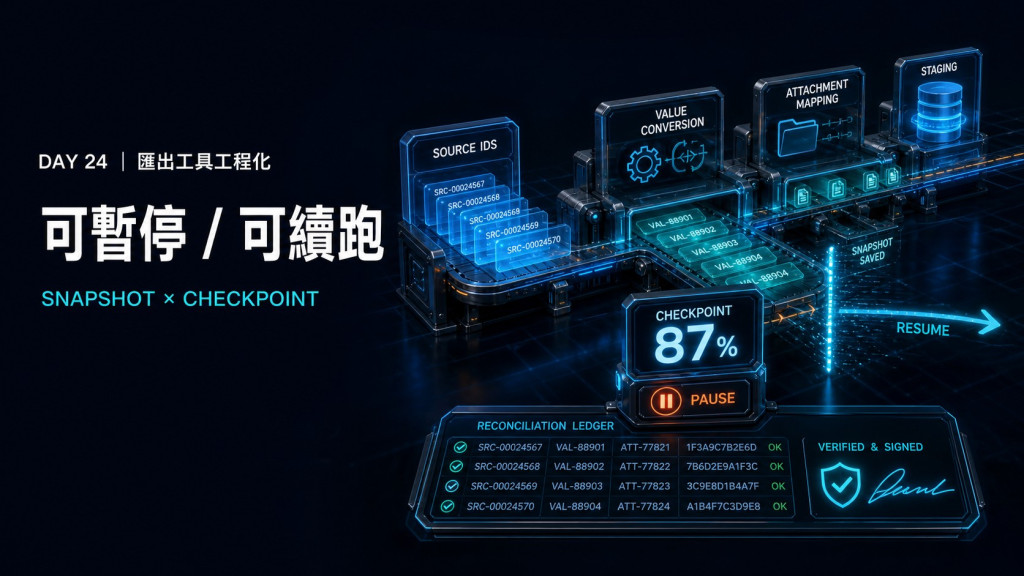
跑了四個小時的匯出在 87% 斷線。如果只能從頭再來,這個週末的遷移窗口就沒了。昨天把撈什麼考古清楚了,今天講怎麼撈:匯出工具的工程化。它不是一支跑一次就丟的 script,是一個要在生產環境、有限窗口、不容出錯條件下運作的批次系統。
以前在 Oracle Agile PLM 嘗試批次導出大批量資料時,常面臨工具層面的崩潰:
OutOfMemoryError;Mini-PLM 遷移團隊設計的工程化匯出工具,將抽取、狀態管理與串流徹底解耦:
抽取邏輯全部放在 SQL 檔,工具只負責執行,不把查詢邏輯寫進程式碼。理由:考古(Day 23)的產出就是一批驗證過的 SQL,讓它直接成為執行資產,改邏輯不用改程式,review 抽取規則看 SQL 檔就好。工具的職責收斂成讀 SQL、分批執行、寫目的地、管理進度。
輸出走雙目的地:CSV 串流(人工抽查、給對方系統的交付檔)與 Staging DB 直寫(正式管道)。串流的意義在記憶體,百萬筆結果集逐批 fetch、逐批寫出,恆定記憶體佔用。一次 fetchAll 在大表上就是 OOM。
開發流程用 TDD 配真實資料庫驗證。匯出工具特別適合 TDD:輸入輸出定義極清楚(給定來源資料、期望匯出形狀),而抽取邏輯的邊角(版本判定、值轉換)恰恰最容易錯。測試跑在真實資料庫上(配可拋棄 schema),Day 12 講過 H2 會騙人,遷移工具的 SQL 方言問題更是只有真 DB 才現形。
工具用一個輕量的本地任務庫(SQLite)管理執行狀態:每個「表 × 批次」是一個任務,狀態機 PENDING → RUNNING → DONE / FAILED。暫停等於停止領新任務,續跑從 PENDING 與 FAILED 繼續,重試把 FAILED 重置。
核心設計是冪等性:斷點前已寫入的批次要能安全重跑。目的地寫入以自然鍵 upsert,或先清本批範圍再寫,重跑不產生重複資料。「87% 斷線」從災難變成續跑、喝口水。
List 值轉換:來源存內部 ID,依對照表轉顯示值。坑在已停用的選項值:舊資料引用著早已下架的選項,對照表裡沒有。策略要先定(保留原 ID 標記、或人工對映表補值),不能讓轉換靜默吐空值。
多階層連動值:層級式選單存成 A|B|C 組合字串,解析要處理分隔符衝突,值本身含 | 的跳脫。
附件對應:附件 metadata 鏈(物件、附件關聯、檔案主檔)加實體檔案路徑換算(檔案 ID 按規則對映到檔案庫的分層目錄)。每筆換算出的路徑做存在性與 checksum 核對,「metadata 有、檔案不在」的孤兒要列清單給業務裁決。
來源是還在服役的系統。查詢加資源限制(批次大小、批間隔),避免拖垮線上使用者;密碼不落地,連線資訊走環境變數或暫存輸入,不進設定檔與版控;開發期預覽限量,LIMIT 先看形狀,不掃全表。
SQL 為唯一真相,任務庫給斷點續跑(配冪等寫入),轉換做好 List 值、連動值、附件鏈三件事,再加上對生產環境的禮貌。Migration 篇到此收束,明日 Day 25 回到系統本身:檔案管理與附件,版本控制與下載授權。


 iThome鐵人賽
 看影片追技術